발표자료 다운로드 — 구조 하나가 만드는 네 가지 효과
기관 정보화 담당자 교육용 개념 브리핑의 2부다. 1부가 가상화·컨테이너·클라우드 네이티브의 구조 차이를 세웠다면, 2부는 그 구조가 실제 운영에서 무엇을 바꾸는지만 다룬다. 제품 이름과 설정 방법은 여기서도 걷어냈다.
효과를 좋은 말로 나열하지 않고 네 가지로 끊어 각각 수치와 함께 붙였다. 한계도 같은 자리에서 정직하게 짚는다 — 이점은 도입 즉시 구조적으로 따라오지만 한계는 조건부이고 보완책이 있다는 것이 이 자료의 균형점이다.
아래 버튼을 누르면 슬라이드 8쪽을 PDF 한 파일로 받을 수 있다.
CNF 백서 구독하기🔔
새로운 백서가 발간되면 가장 먼저 안내드려요!
CNF가 전하는 최신 백서와 클라우드 인사이트를 가장 빠르게 만나보실 수 있습니다.
진심으로 구독 부탁드립니다 🙏
발표 영상으로 먼저 보기
네 가지 효과는 서로 이어져 있어 슬라이드만 보면 왜 이 순서인지가 끊긴다. 관리에서 속도로, 속도에서 백업으로 넘어가는 대목은 말로 들으면 훨씬 빨리 붙는다.
발표 영상은 슬라이드 순서 그대로 관리에서 시작해 다섯 문장 요약까지 이어진다.
영상에서 다루는 순서는 다음과 같다.
- 관리 — 고치기에서 통째 교체로 바뀌는 운영 방식
- 속도 — 29초와 1초의 차이가 자동 확장을 가르는 이유
- 백업 — 통째 스냅샷에서 데이터만 남기기까지
- AI — 다섯 조각이 모두 쿠버네티스 위에서 도는 구조
- 한계 — 커널 공유와 레거시, 그리고 보완책
- 무엇부터 옮길지 가르는 세 가지 질문
- 오늘 내용을 다섯 문장으로
구조 차이 자체를 아직 정리하지 않았다면 1부에 해당하는 가상화·컨테이너·클라우드 네이티브 구조 비교를 먼저 보는 편이 순서에 맞다. 클라우드 네이티브라는 말 자체를 처음부터 정리하려면 클라우드 네이티브란? 개념·구성요소·도입 전략 가이드가 출발점이다.
이 발표자료가 답하는 다섯 가지 질문
구조는 이해했는데 그래서 무엇이 좋아지느냐는 질문에 막히는 지점만 골랐다.
- 컨테이너로 바꾸면 운영 인력이 정말 줄어드는가 — 무엇이 줄어서 줄어드는가
- 기동이 빨라지면 실제로 무엇이 달라지는가
- 백업과 재해복구는 어떻게 가벼워지는가
- AI 인프라를 하려면 별도의 기반을 새로 만들어야 하는가
- 컨테이너가 맞지 않는 자리는 어디이고, 무엇부터 시작해야 하는가
질문마다 답이 되는 슬라이드를 아래 순서대로 붙였다. 슬라이드 이미지를 누르면 크게 볼 수 있다.
관리 — 고치기에서 통째 교체로
첫 번째 효과는 관리다. 관리 대상이 줄어드는 것이 아니라 관리라는 행위 자체가 달라진다.
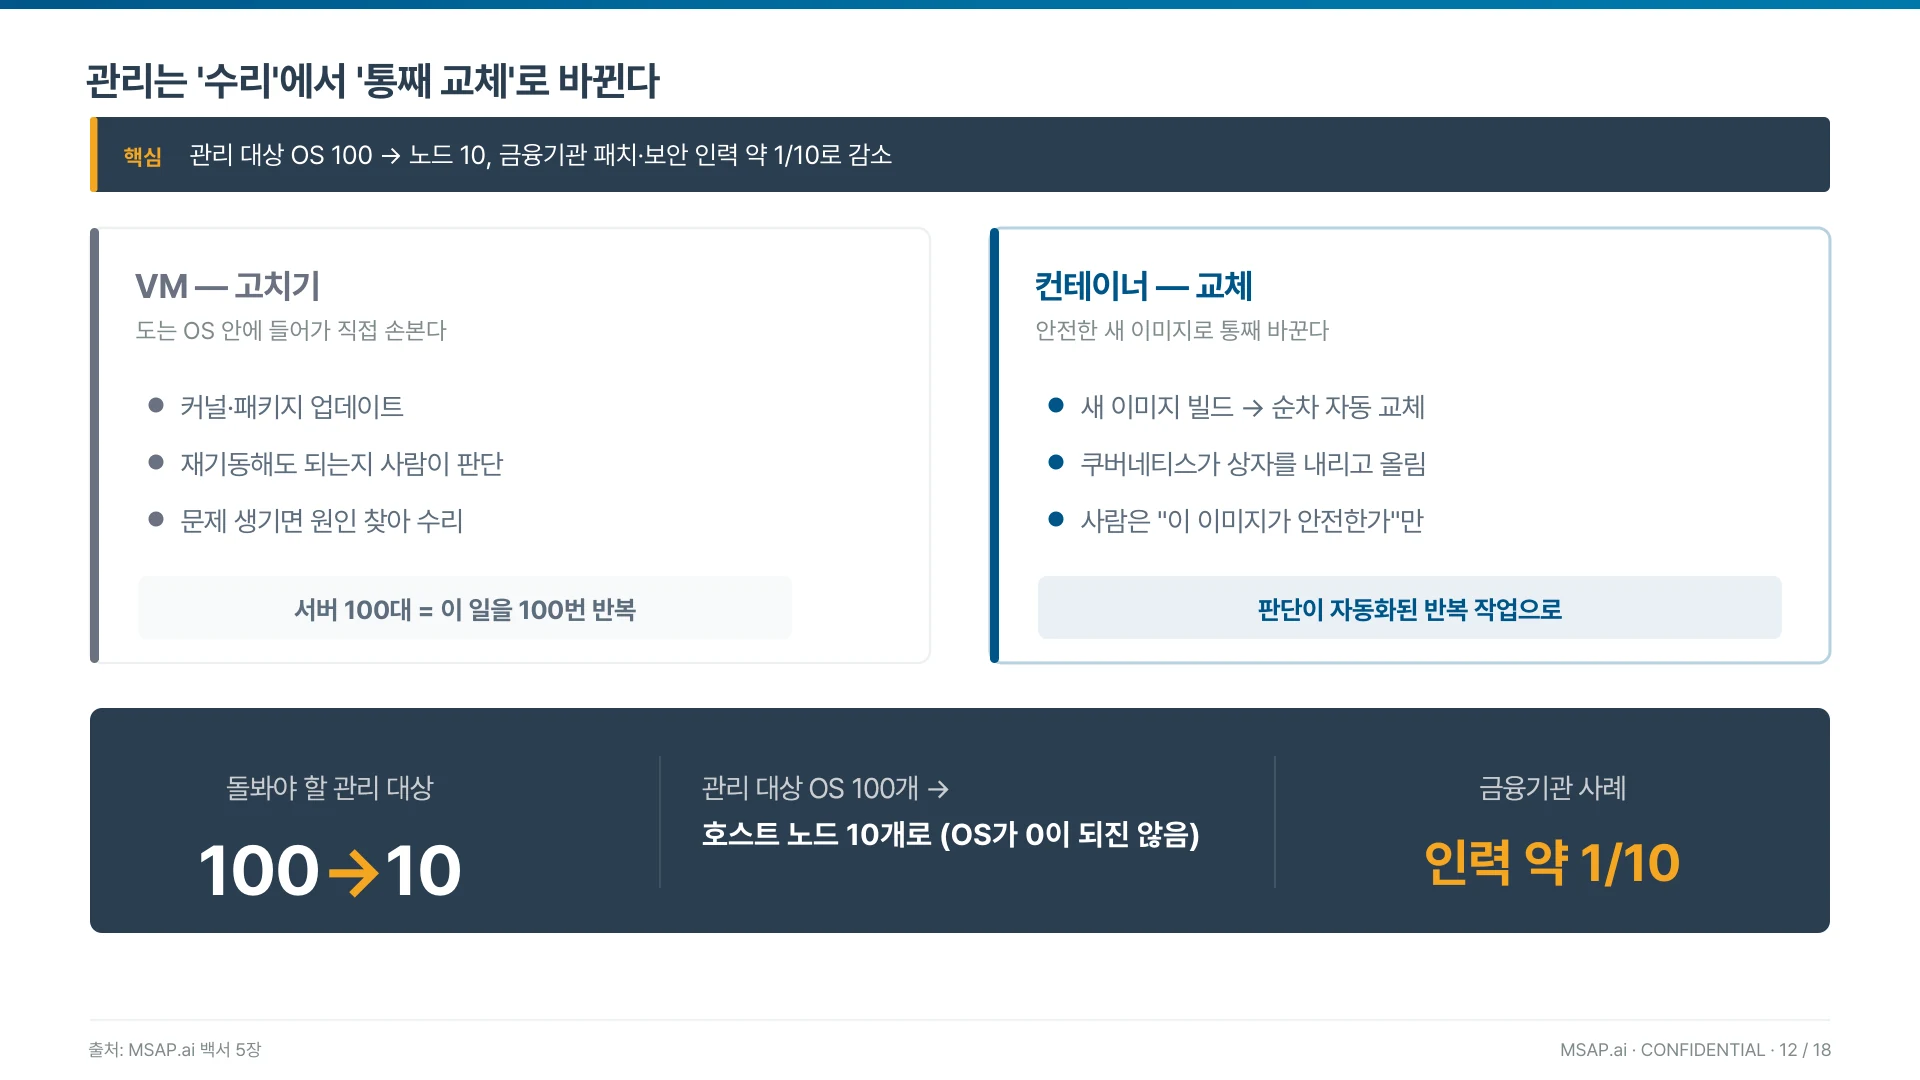
▲ 관리가 ‘고치기’에서 ‘통째 교체’로 바뀌며 돌봐야 할 OS가 100개에서 노드 10개 수준으로 줄어든다 (발표자료 2쪽)
가상화에서 관리는 고치기다. 이미 돌고 있는 OS 안으로 들어가 커널이나 패키지를 업데이트하고, 재기동해도 되는지 사람이 판단하고, 문제가 생기면 원인을 찾아 수리한다. 서버가 100대면 이 일을 100번 반복한다.
컨테이너에서 관리는 교체다. 안전한 새 이미지를 만들어 통째로 바꾸고, 쿠버네티스가 상자를 하나씩 내리고 올린다. 사람이 판단할 것은 이 이미지가 안전한가 하나로 좁혀진다.
그래서 돌봐야 할 관리 대상이 OS 100개에서 호스트 노드 10개 수준으로 줄어든다. 한 금융기관에서는 패치·보안 인력이 약 10분의 1로 감소했다. 서버 수를 줄여서가 아니라 관리해야 할 OS를 줄여서 나온 결과다. 다만 노드의 OS가 0이 되는 것은 아니므로, 사라진 것은 OS 자체가 아니라 OS를 개별적으로 돌보는 반복 작업이라고 읽는 편이 정확하다.
이 반복을 걷어내는 것이 컨테이너화의 본래 목적이기도 하다 — 실행 환경을 이미지로 고정해 어디서든 같은 결과를 재현하는 것이 첫 번째 이점으로 꼽힌다(컨테이너화의 필요성 및 장점).
속도 — 29초와 1초가 가르는 것
두 번째 효과는 속도다. 가상머신은 다시 짓고, 컨테이너는 다시 켠다.
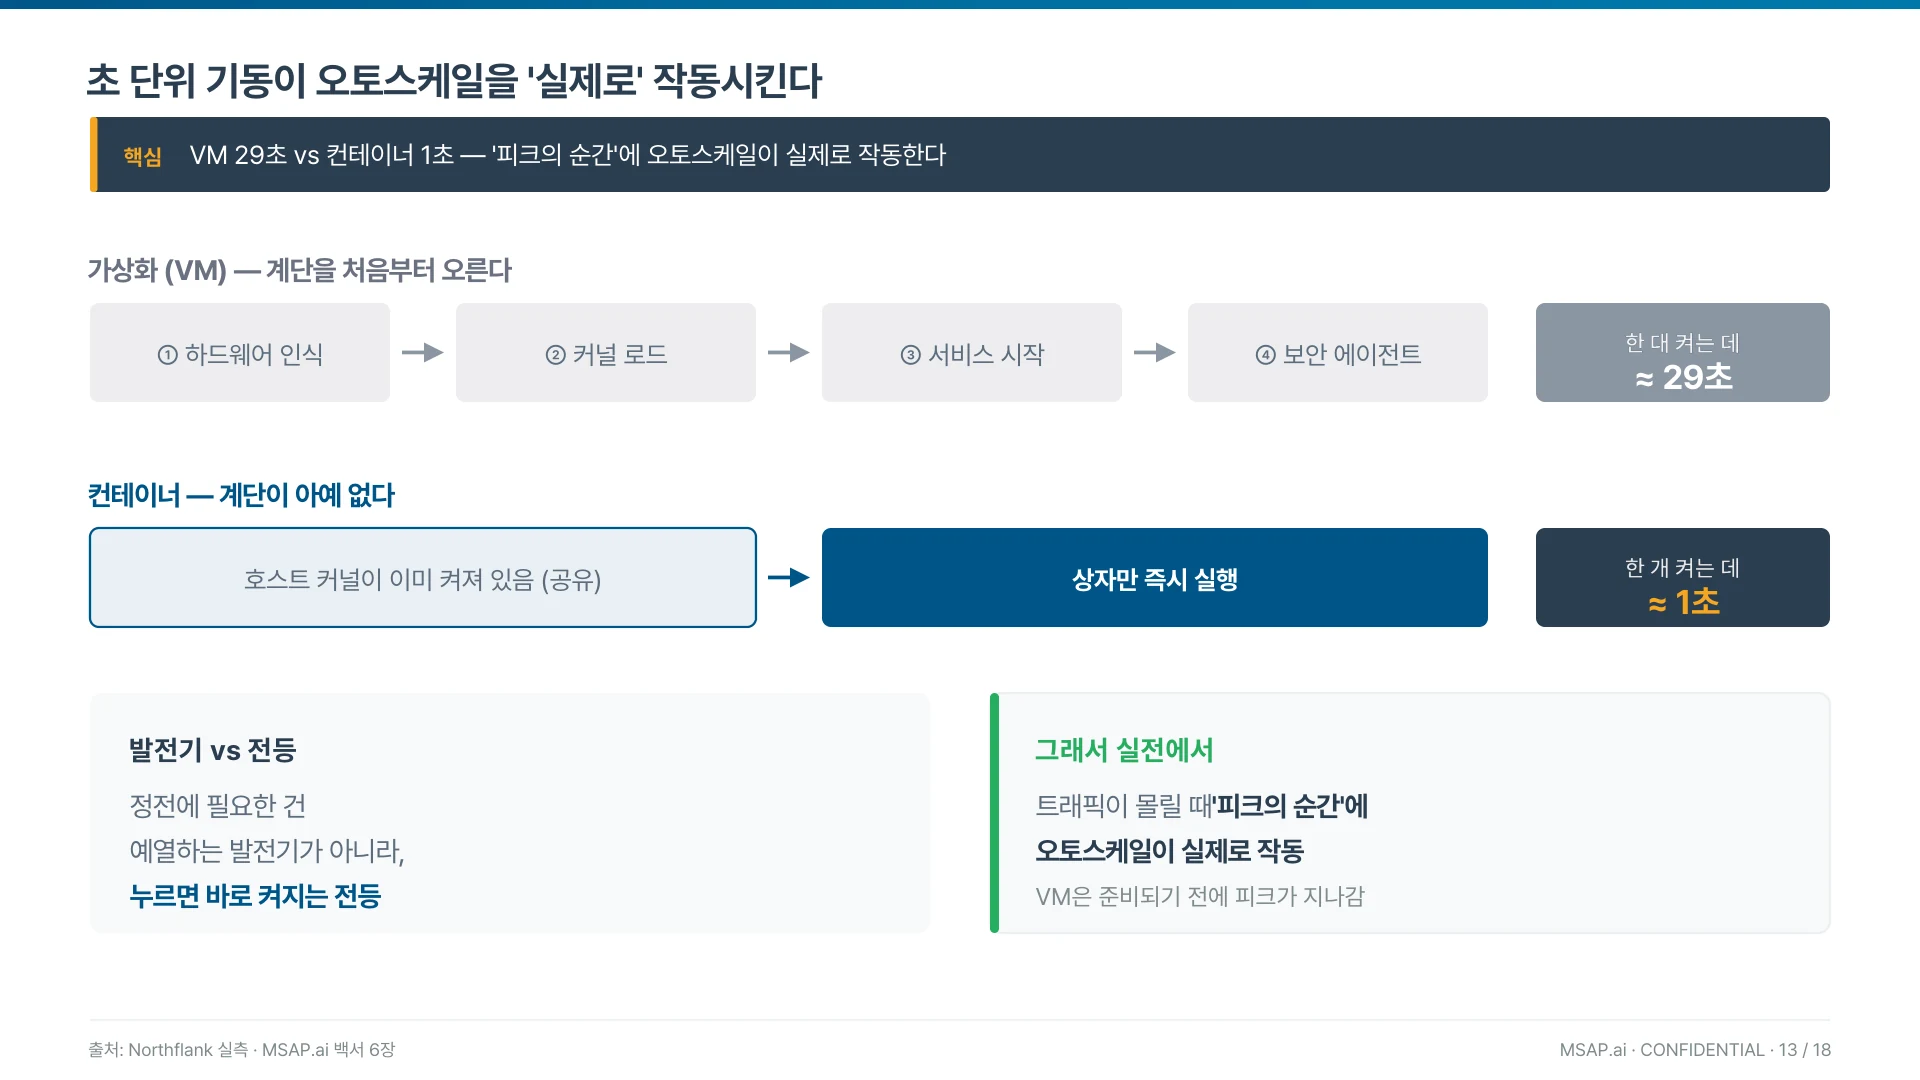
▲ 기동이 29초에서 1초로 줄어 트래픽이 몰리는 바로 그 순간에 자동 확장이 실제로 작동한다 (발표자료 3쪽)
가상머신은 켤 때마다 하드웨어 인식부터 커널 로드, 서비스 시작, 보안 에이전트까지 계단을 처음부터 오른다. 그래서 한 대에 약 29초가 걸린다. 컨테이너에는 이 계단이 아예 없다. 호스트 커널이 이미 켜져 있으니 상자만 올리면 되고, 약 1초가 걸린다.
이 차이가 중요한 이유는 평균이 아니라 피크에 있다. 정전이 났을 때 필요한 것은 예열하는 발전기가 아니라 누르면 바로 켜지는 전등이다. 트래픽이 갑자기 몰릴 때 컨테이너는 바로 그 순간에 자동 확장이 실제로 작동하고, 가상머신은 새 서버가 준비되기도 전에 피크가 지나가 버린다.
자동 확장은 켜 두기만 하면 되는 기능이 아니라 기동 시간이 받쳐 줄 때만 의미를 갖는 기능이다. 초 단위 기동이 오토스케일을 실제로 작동시킨다는 말은 그런 뜻이다.
백업 — 통째 스냅샷에서 데이터만 남기기
세 번째 효과는 백업과 복구다. 집을 통째로 사진 찍느냐, 설계도만 보관하느냐의 차이다.
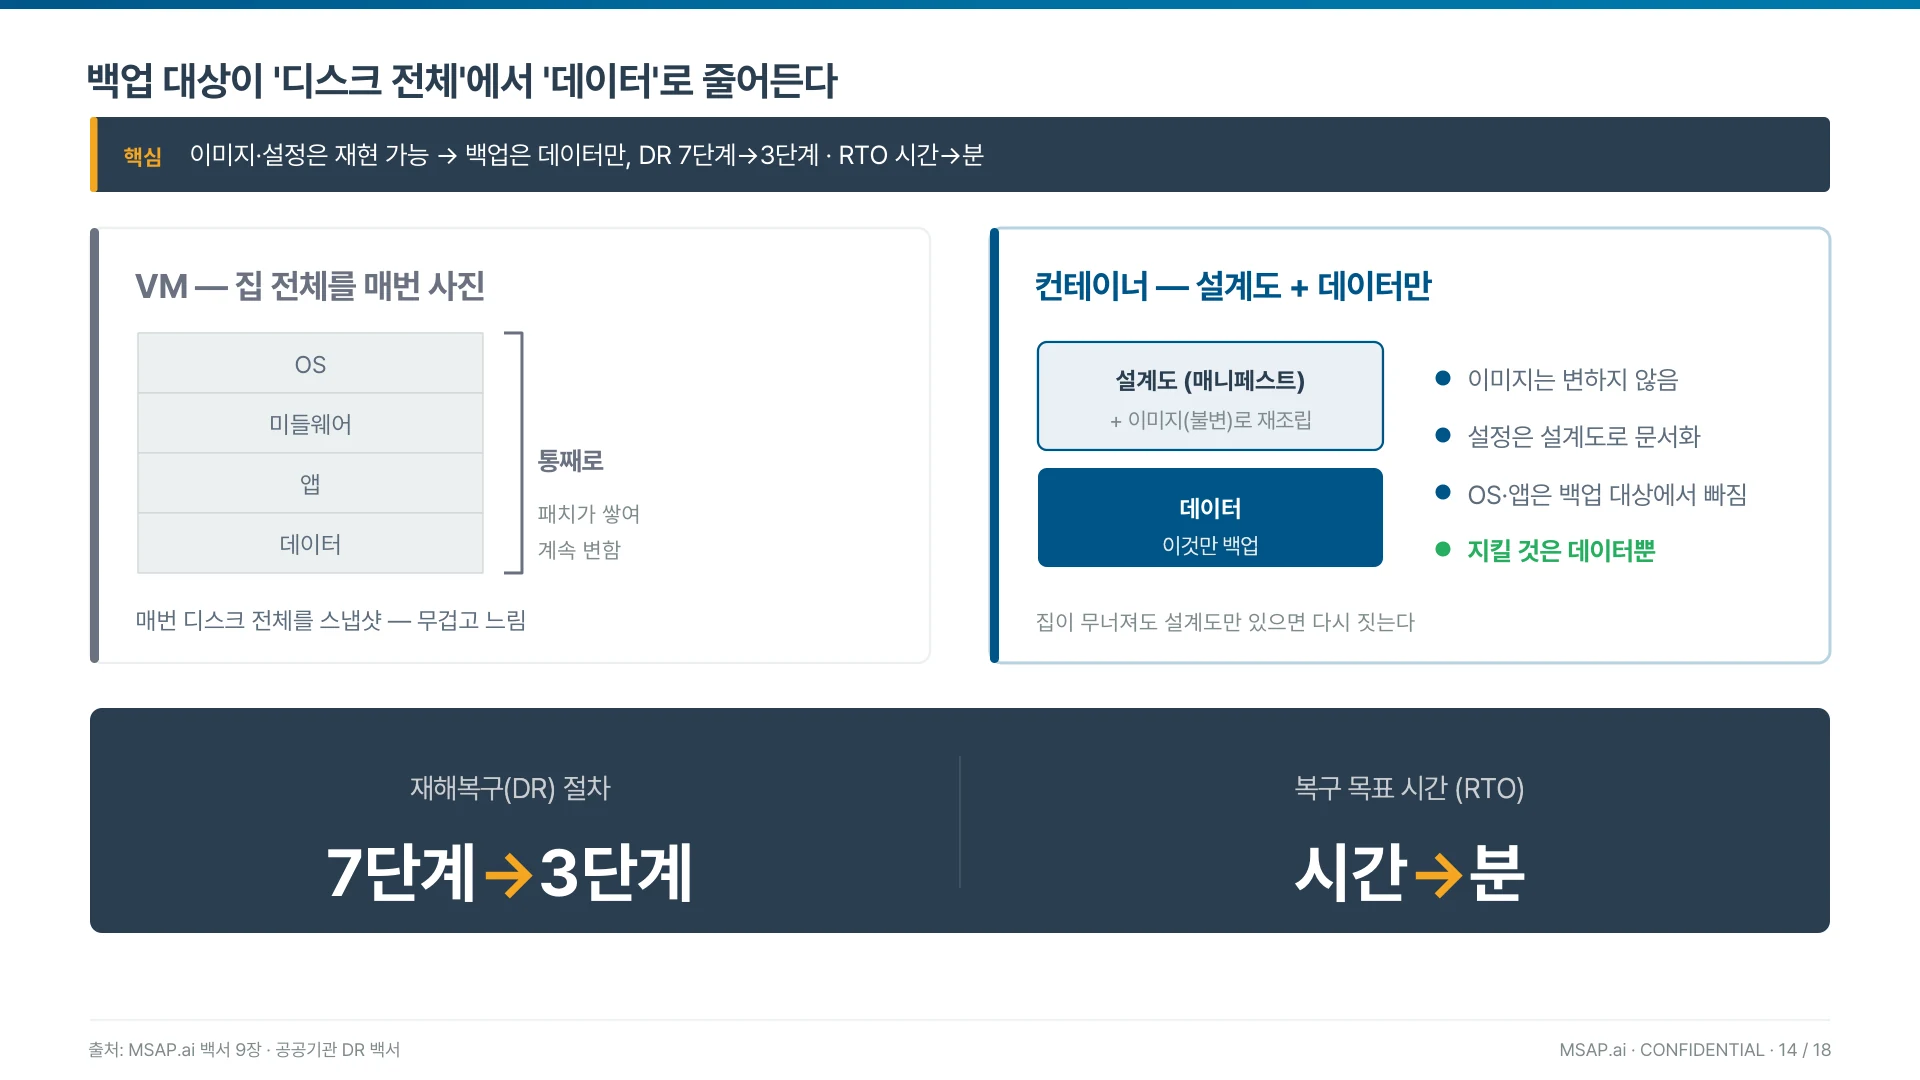
▲ 이미지는 변하지 않고 설정은 매니페스트로 남아 백업할 것은 데이터뿐이다 — DR 7단계에서 3단계로 (발표자료 4쪽)
가상머신 백업은 OS와 미들웨어, 앱, 데이터를 매번 통째로 스냅샷 찍는다. 패치가 쌓이며 대상이 계속 변하니 무겁고 느리다.
컨테이너는 다르다. 이미지는 변하지 않고, 설정은 매니페스트라는 설계도로 문서화돼 있다. 그래서 실제로 백업할 것은 데이터뿐이고 OS와 앱은 백업 대상에서 아예 빠진다. 집이 무너져도 설계도가 있으면 다시 짓는 것과 같다.
이미지가 변하지 않는다는 성질은 컨테이너 이미지가 읽기 전용 레이어를 쌓아 만들어지고 실행 시점에만 쓰기 가능한 레이어가 얹히는 구조에서 나온다(컨테이너 이미지와 레이어). 백업 대상이 줄어드는 근거가 운영 규칙이 아니라 이미지 구조 자체에 있다는 뜻이다.
그 결과 재해복구 절차가 7단계에서 3단계로 줄고, 복구 목표 시간도 시간 단위에서 분 단위로 짧아진다. 백업 용량이 줄어드는 것은 부수 효과이고, 본질은 복구 절차에서 사람이 판단할 단계가 줄어든다는 쪽이다.
AI — 다섯 조각이 모두 쿠버네티스 위에 있다
네 번째 효과는 AI다. AI 인프라도 결국 클라우드 네이티브 위에서 돈다.
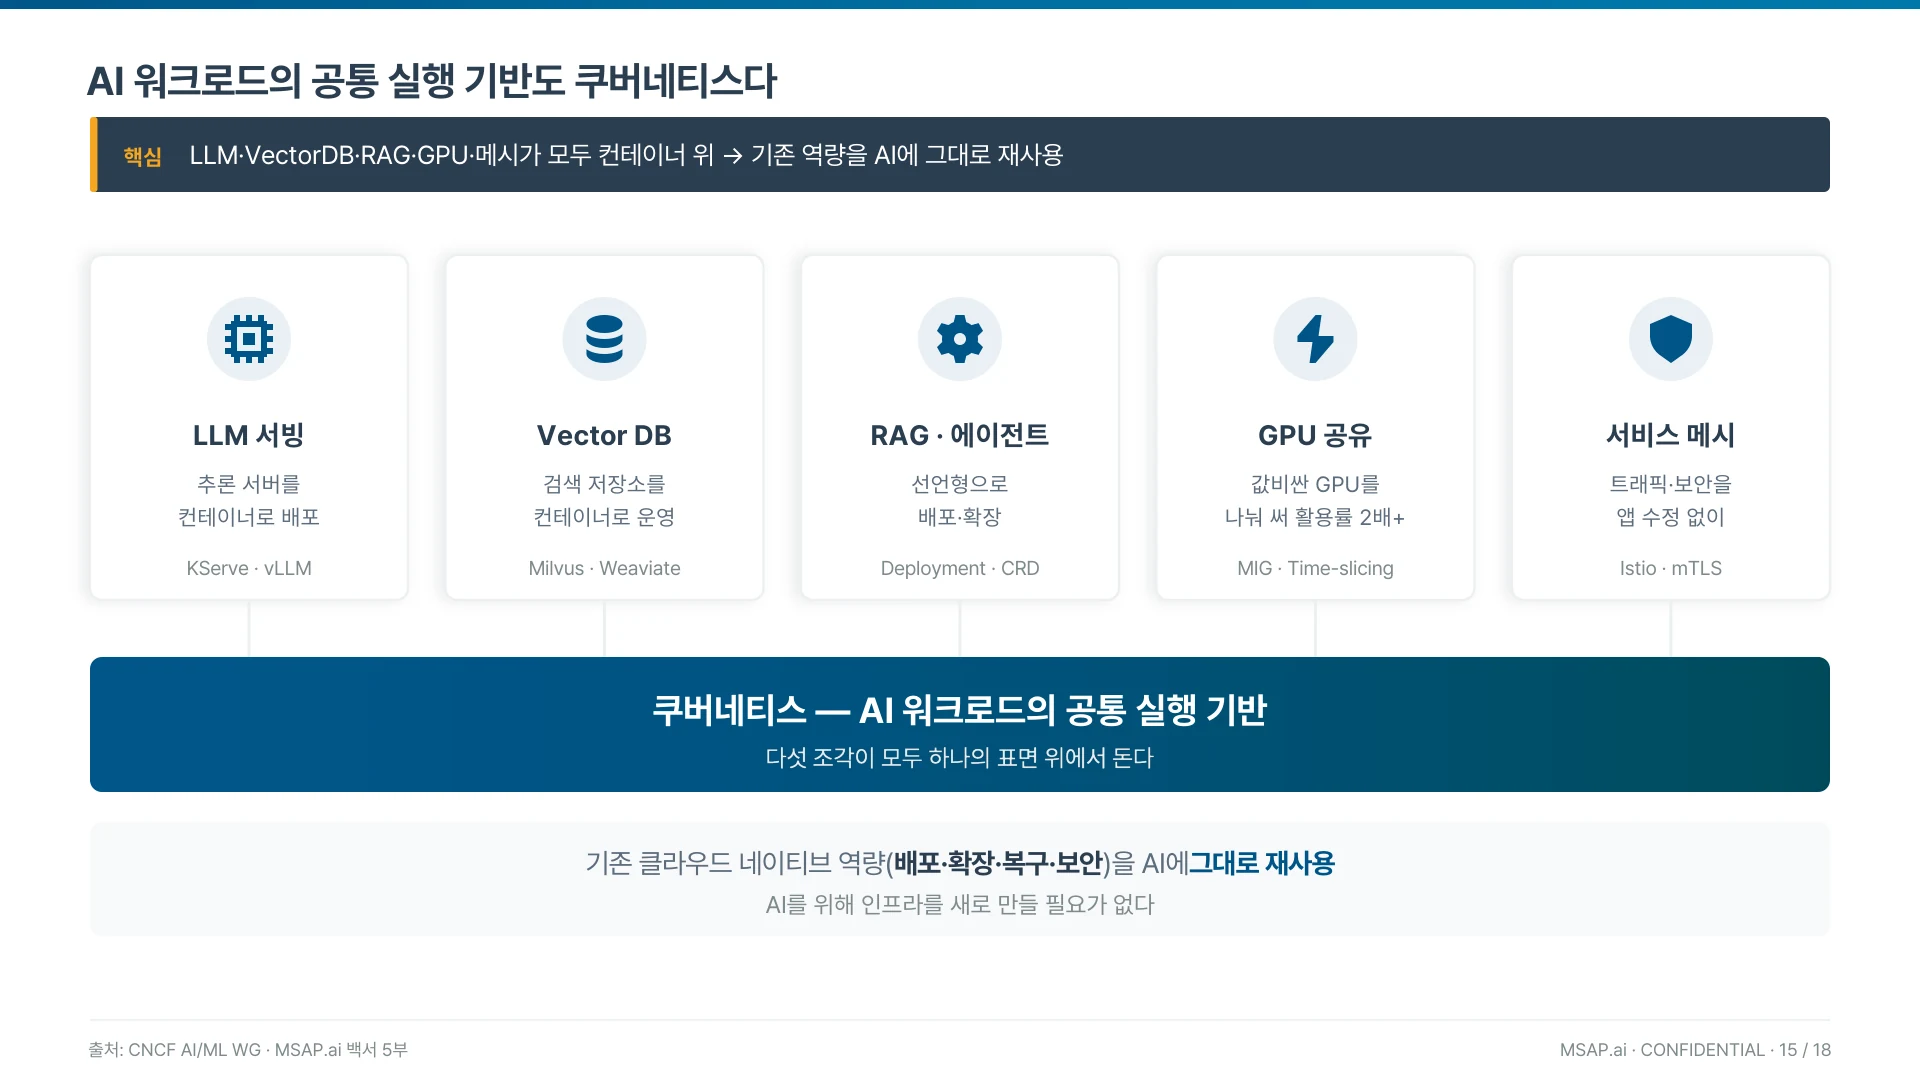
▲ LLM 서빙·Vector DB·RAG·GPU 공유·서비스 메시가 모두 컨테이너로 쿠버네티스 위에서 돈다 (발표자료 5쪽)
AI 시스템은 다섯 조각으로 나눌 수 있다. 추론을 돌리는 LLM 서빙, 검색을 담당하는 Vector DB, 이들을 엮는 RAG와 에이전트, 값비싼 GPU를 나눠 쓰는 GPU 공유, 그리고 트래픽과 보안을 다루는 서비스 메시다.
이 다섯 조각이 모두 컨테이너로 패키징되어 쿠버네티스라는 하나의 표면 위에서 돈다. 그래서 앞에서 본 배포·확장·복구·보안 같은 역량을 AI 워크로드에도 그대로 재사용할 수 있다. AI를 하겠다고 인프라를 처음부터 새로 만들 필요가 없다는 뜻이다.
반대 방향의 변화도 함께 일어난다 — 쿠버네티스가 AI 워크로드를 받아 내면서 운영의 관심이 인프라 계층에서 애플리케이션 계층으로 옮겨 가고 있다(AI가 바꾸는 쿠버네티스 운영의 미래).
거꾸로 말하면 클라우드 네이티브 기반이 없는 조직은 AI를 시작할 때 기반부터 만들게 된다. AI가 컨테이너 전환의 이유가 되는 자리가 여기다.
한계 — 만능은 아니다, 무엇부터 시작할까
좋은 점만 말하면 신뢰를 얻기 어렵다. 한계도 같은 무게로 짚는다.
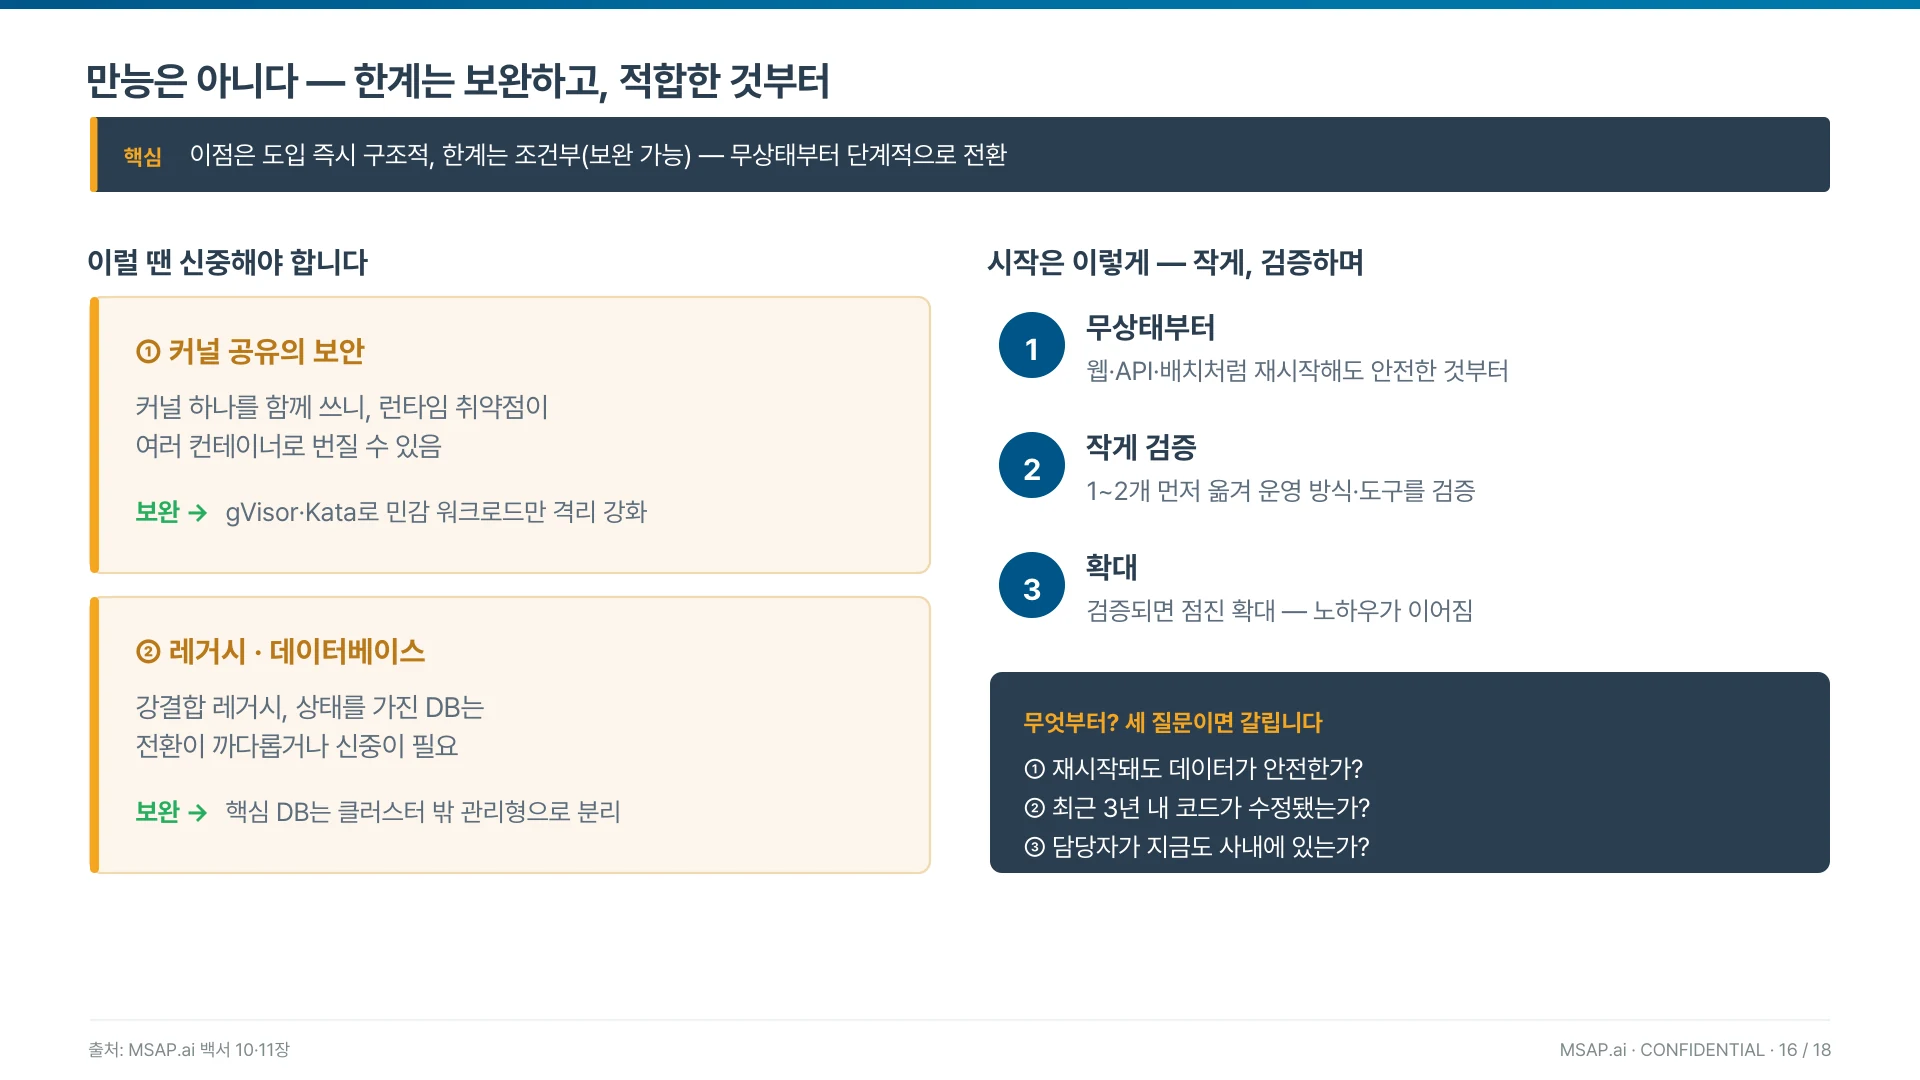
▲ 커널 공유와 레거시라는 두 한계는 각각 보완책이 있고, 전환은 무상태 앱부터 작게 시작한다 (발표자료 6쪽)
한계는 크게 둘이다. 첫째, 커널을 함께 쓰므로 런타임에 취약점이 생기면 여러 컨테이너로 번질 수 있다. 이것은 gVisor나 Kata Containers 같은 도구로 민감한 워크로드만 격리를 강화해 보완한다. 둘째, 강하게 얽힌 레거시나 상태를 가진 데이터베이스는 전환이 까다롭다. 핵심 데이터베이스는 클러스터 밖 관리형 서비스로 분리하는 편이 정답에 가깝다.
두 한계의 성격이 이점과 다르다는 점이 중요하다. 이점은 구조를 바꾸는 순간 따라오지만, 한계는 워크로드 성격에 따라 나타나는 조건부이고 각각 알려진 보완책이 있다.
시작은 작게 한다. 재시작해도 안전한 무상태 앱부터 한두 개를 먼저 옮겨 검증하고, 확인되면 넓힌다. 무엇부터 옮길지는 세 가지 질문이면 대부분 갈린다 — 재시작해도 안전한가, 상태를 밖에 둘 수 있는가, 커널을 공유해도 되는가.
검증한 뒤 어디까지 넓힐지는 단계로 나눠 잡는 편이 안전하다. 전환 순서를 조직 단위로 그려 두면 무상태 앱 다음에 무엇이 오는지가 분명해진다(클라우드 네이티브 전환 로드맵 — 5단계로 그리는 마이그레이션 전략).
다섯 문장으로 수렴한다
1부와 2부를 합쳐 다섯 문장으로 정리된다.
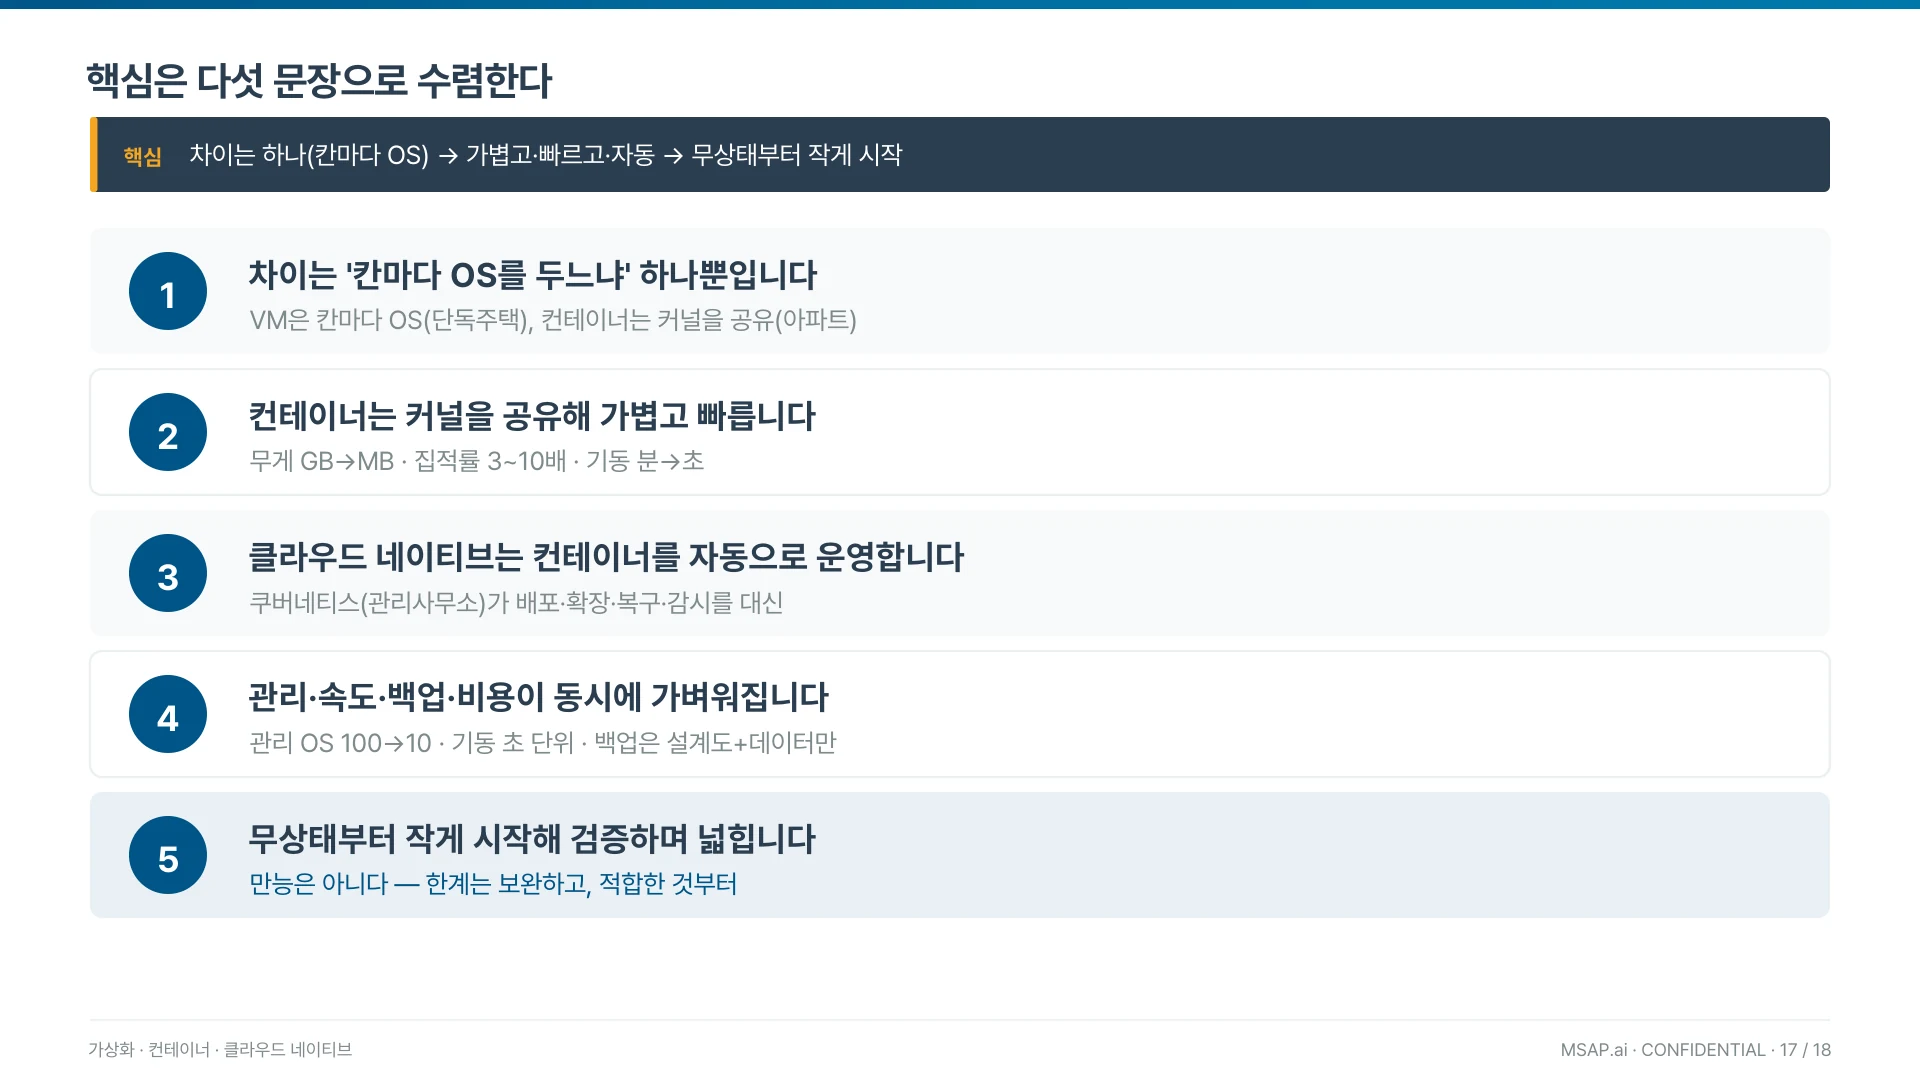
▲ 차이는 칸마다 OS 하나 — 가볍고 빠르고 자동으로 운영되며, 무상태부터 작게 시작하면 된다 (발표자료 7쪽)
첫째, 세 개념의 차이는 칸마다 OS를 두느냐 하나뿐이다. 둘째, 컨테이너는 커널을 공유해 가볍고 빠르다. 셋째, 클라우드 네이티브는 그 컨테이너를 자동으로 운영한다. 넷째, 그래서 관리와 속도, 백업과 비용이 동시에 가벼워진다. 다섯째, 다만 만능은 아니니 무상태부터 작게 시작해 검증하며 넓히면 된다.
질문도 함께 바뀐다. 어떤 OS로 바꿀까가 아니라 OS를 어떻게 운영할까가 된다.
핵심 정리
- 관리는 고치기에서 통째 교체로 바뀌고, 돌봐야 할 대상이 OS 100개에서 노드 10개 수준으로 줄어든다.
- 기동이 약 29초에서 약 1초로 짧아져 피크의 순간에 자동 확장이 실제로 작동한다.
- 이미지는 불변이고 설정은 매니페스트로 남으므로 백업할 것은 데이터뿐이고, 재해복구는 7단계에서 3단계로 줄어든다.
- AI의 다섯 조각이 모두 쿠버네티스 위에서 돌아 기존 역량을 그대로 재사용한다.
- 한계는 커널 공유와 레거시 둘이며 각각 보완책이 있고, 전환은 무상태 앱부터 작게 시작한다.
자주 묻는 질문
컨테이너로 바꾸면 운영 인력이 정말 줄어듭니까?
줄어드는 것은 서버 수가 아니라 관리해야 할 OS의 수입니다. 관리 방식이 개별 수리에서 이미지 통째 교체로 바뀌면서 돌봐야 할 대상이 OS 100개에서 호스트 노드 10개 수준으로 줄고, 한 금융기관에서는 패치·보안 인력이 약 10분의 1로 감소했습니다.
기동 시간이 29초에서 1초로 줄면 무엇이 달라집니까?
평균 응답 속도가 아니라 피크 대응이 달라집니다. 트래픽이 갑자기 몰리는 순간에 컨테이너는 자동 확장이 실제로 작동하지만, 가상머신은 새 서버가 준비되기 전에 피크가 지나가 버립니다.
컨테이너 환경에서는 무엇을 백업합니까?
데이터만 백업합니다. 이미지는 변하지 않고 설정은 매니페스트로 문서화돼 있어 OS와 앱은 백업 대상에서 빠집니다. 그 결과 재해복구 절차가 7단계에서 3단계로 줄고 복구 목표 시간이 시간 단위에서 분 단위로 짧아집니다.
AI 인프라를 하려면 별도의 기반을 새로 만들어야 합니까?
새로 만들지 않아도 됩니다. LLM 서빙과 Vector DB, RAG와 에이전트, GPU 공유, 서비스 메시라는 다섯 조각이 모두 컨테이너로 쿠버네티스 위에서 돌기 때문에, 배포와 확장, 복구와 보안 역량을 그대로 재사용할 수 있습니다.
컨테이너가 맞지 않는 워크로드는 무엇입니까?
커널 수준의 격리가 필요한 민감한 워크로드와 강하게 얽힌 레거시, 상태를 가진 핵심 데이터베이스입니다. 앞의 것은 gVisor나 Kata Containers로 격리를 강화해 보완하고, 데이터베이스는 클러스터 밖 관리형 서비스로 분리하는 편이 좋습니다.
전환은 무엇부터 시작해야 합니까?
재시작해도 안전한 무상태 앱부터 시작합니다. 한두 개를 먼저 옮겨 검증하고 확인되면 넓히며, 재시작해도 안전한가, 상태를 밖에 둘 수 있는가, 커널을 공유해도 되는가 세 질문이면 대상 대부분이 갈립니다.
컨테이너 전환의 이점과 한계는 같은 성격입니까?
다릅니다. 이점은 구조를 바꾸는 순간 따라오는 구조적 결과이고, 한계는 워크로드 성격에 따라 나타나는 조건부이며 각각 알려진 보완책이 있습니다.
참고 리소스
- 가상화·컨테이너·클라우드 네이티브 구조 비교
- 클라우드 네이티브란? 개념·구성요소·도입 전략 가이드
- 가상화의 한계, 클라우드 네이티브 아키텍처가 해결하는 법
- 클라우드 네이티브 4대 요소 정리 — 컨테이너·MSA·CI/CD·DevOps
- 쿠버네티스(Kubernetes)란 무엇인가 — 개념과 도입 이유
- 컨테이너와 쿠버네티스 — 각각의 역할과 함께 쓰는 이유
- 가상화 엔지니어를 위한 쿠버네티스 — 패러다임이 다른 이유
- 쿠버네티스가 필요한 이유 — 구글 데이터센터에서 시작된 컨테이너 혁명
- 쿠버네티스 Pod 완벽 가이드 — 개념·생명주기·멀티컨테이너 패턴
- VM에서 VM으로 전환은 중복 투자일 뿐 — 진짜 현대화란
- 컨테이너 런타임이란? containerd·CRI-O·Docker 비교
- Podman이란? 컨테이너 패러다임의 변화